Ik besteedde mijn geld om LLM’s te benchmarken op Nederlandse examens – zodat jij dat niet hoeft te doen
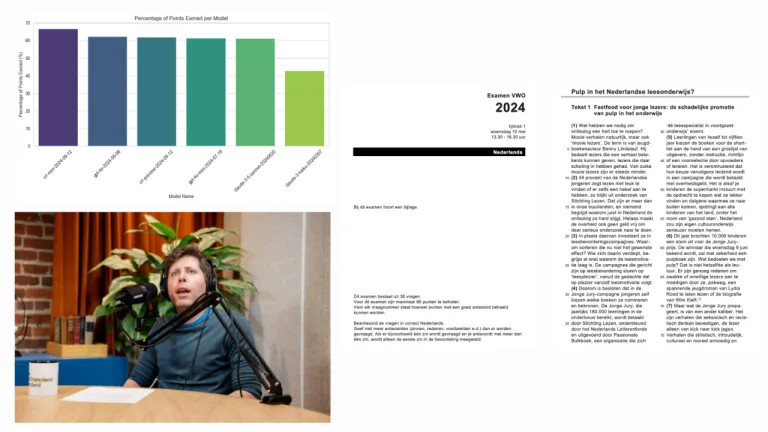
In dit blog deel ik mijn ervaringen met het benchmarken van verschillende grote taalmodellen (LLM’s) op basis van Nederlandse staatsexamens. Veel benchmarks richten zich op Engels, waardoor specifieke prestaties in het Nederlands vaak onderbelicht blijven. Ik verzamelde en verwerkte meer dan 12.000 PDF’s met examenvragen om inzicht te krijgen in hoe modellen zoals o1-mini, GPT-4o en Claude-3 presteren op begrijpend lezen en andere Nederlandstalige taken. Het resultaat? o1-mini blijkt beter én goedkoper te presteren dan duurdere modellen. Dit blog biedt waardevolle inzichten voor bedrijven die Nederlandstalige AI-toepassingen willen bouwen of opschalen.